引入
对于学生信息有如下结构
struct student {
	id int,
	name string,
}
如果要在一堆学生数组中查找某一个学生的信息,那么可以用遍历的方法,例如我想通过学号查找学生信息那么可以这么写
{id:2,name:"李四"}
{id:1,name:"张三"}
{id:3,name:"王五"}
foreach s in students {
	if s.id == 3 {
		print(s.name)
	}
}
但是这样查找效率太低了,因此我们想到为什么不直接将学号当作下标访问,例如我想找学号为3的,直接使用arr[3]
在存储阶段我们将id作为数组下标,例如我想存放1-3的学号学生信息,我就创建空间为4的数组,然后将学号1对应的信息放入arr[1]中,学号2放入arr[2]中,以此类推。这样查找的时候就能直接根据学号定位下标。恭喜你发明了Hash表!
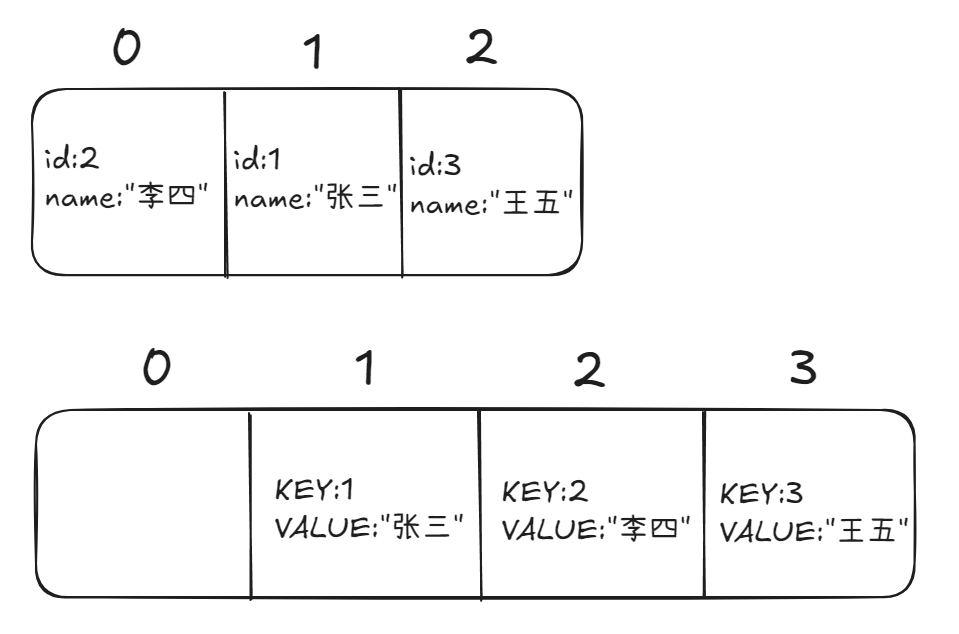
我们常用的字典就是以Hash实现的,通过set(1,"张三")键值对来保存数据
Hash表可以看作一个数组,数组内每一个空间存放键值对信息,并且数组的下标与KEY对应,这样通过KEY就可以直接定位到数据,平均时间复杂度O(1),最坏为O(n)
Hash函数/散列函数
{id:1001,name:"张三"}
{id:1002,name:"李四"}
{id:1003,name:"王五"}
已知上面的信息,id是从1001开始的,我们不可能创建一个空间为1004的数组,因为我们只需要存放三个数据,因此需要用到散列函数。
散列函数维护了键值对之间的映射关系
最常用的映射关系如下
- 直接定址(线性映射):
- 除留余数:H(Key) = key % p
直接定址
满足H(Key) = Key或H(Key) = k * Key + b
取偏移量b = 1000,则H(Key) = Key – 1000,但是这种方法只适用于Key连续的情况,如果Key稀疏且跨度大依旧会带来空间上的浪费
优点:映射简单,不会产生碰撞
缺点:要求Key连续分布否则会带来大量空间浪费
除留余数
H(Key) = key % p,(p一般取小于等于表长的最大质数)
优点:能够将Key放到连续空间
缺点:会产生Key碰撞,降低散列表性能
碰撞:两个Key通过散列函数计算后映射到数组同一个下标
散列表性能决定因素:
- 散列函数(选用哪种映射策略)
- 装填因子(表中元素数量 / 表长)
- 碰撞处理方法
装填因子:装填因子 = 表中元素数 / 表长。开放定址法一般要求装填因子 < 1(常见阈值 0.7~0.75),超过时需要扩容(再散列)
碰撞处理方法
开放定址法
线性探测法
表尾的下一个位置是表首,碰撞后依次探测下一个位置,直到遇到空闲位置
对于线性探测法删除Key不能直接将下标所在元素删除,因为如果查找的元素在删除元素的后面,那么在线性探测时探测到空会误认为后面没有查找的元素了,导致查找失败。所以删除元素需要打上删除标记。
- 在查找时,遇到空会放弃查找,而删除标记不会影响查找
- 做插入时,空位置和删除标记位置可以插入
弊端:堆积问题
平方探测法
冲突时按照+1²,-1²,+2²,-2²,+3²,-3²,…的顺序进行探测(表尾之后是表首)
表长=某个4k+3的质数(k为正整数) 时一定能探测到所有位置
- 在查找时,遇到空会放弃查找,而删除标记不会影响查找
- 做插入时,空位置和删除标记位置可以插入
拉链法
冲突时通过挂载串联单链表实现查找
- 插入时,头插法和尾插法都可以
- 删除时,直接让上一个节点的尾指针指向下一个节点即可
注意
编程语言 API 里说的 hash(),只是将Key(如字符串)进行转化为一个 int,不含映射。
如Java的String.hashCode()只把字符串变成整数。真正映射到桶,是HashMap容器内部做的事。
手搓HashMap
实现简单的字符串Map
package main

import (
	"fmt"
	"strings"
)

type Node struct {
	Key   string
	Value string
	next  *Node
}
type hash_table []*Node

type HashMap struct {
	hashTable hash_table
	size      int
	capacity  int
}

func NewHashMap(capacity int) *HashMap {
	hashTable := make(hash_table, capacity)
	return &HashMap{
		hashTable,
		0,
		capacity,
	}
}

func (m *HashMap) String() string {
	if m == nil {
		return "MyMap<nil>"
	}

	var builder strings.Builder

	builder.WriteString("MyMap{")
	builder.WriteString(fmt.Sprintf("size:%d, capacity:%d, data:{", m.size, m.capacity))

	first := true

	for _, head := range m.hashTable {
		for node := head; node != nil; node = node.next {
			if !first {
				builder.WriteString(", ")
			}

			builder.WriteString(fmt.Sprintf("%q:%q", node.Key, node.Value))
			first = false
		}
	}

	builder.WriteString("}}")

	return builder.String()
}

func (this *HashMap) Set(key any, value any) {
	// 类型断言
	KEY, ok := key.(string)
	if !ok {
		return
	}
	VALUE, ok := value.(string)
	if !ok {
		return
	}
	// hash化key为Index
	H_IDX := this.index(KEY)
	// 遍历链表是否存在KEY
	// 不为空,遍历链表,检查 key 是否已存在
	for cur := this.hashTable[H_IDX]; cur != nil; cur = cur.next {
		if cur.Key == KEY {
			cur.Value = VALUE
			return
		}
	}

	if float64(this.size)/float64(this.capacity) >= 0.75 {
		fmt.Println("容量不足,触发扩容")
		expandHashTable(this)
		// 扩容后重新计算待插入IDX
		H_IDX = this.index(KEY)
	}

	newNode := &Node{
		Key:   KEY,
		Value: VALUE,
		next:  this.hashTable[H_IDX],
	}
	this.hashTable[H_IDX] = newNode
	this.size++
}

// 获得索引
func (m *HashMap) index(key string) int {
	hash := func(key string) uint64 {
		var h uint64 = 14695981039346656037

		for i := 0; i < len(key); i++ {
			h ^= uint64(key[i])
			h *= 1099511628211
		}

		return h
	}
	return int(hash(key) % uint64(m.capacity))
}

// 扩容
func expandHashTable(m *HashMap) {
	oldTable := m.hashTable
	m.capacity *= 2
	m.hashTable = make(hash_table, m.capacity)

	for _, node := range oldTable {
		for node != nil {
			next := node.next

			idx := m.index(node.Key)
			node.next = m.hashTable[idx]
			m.hashTable[idx] = node

			node = next
		}
	}
}

func (this *HashMap) Get(key any) (any, bool) {
	KEY, ok := key.(string)

	if !ok {
		return nil, false
	}

	H_IDX := this.index(KEY)

	for cur := this.hashTable[H_IDX]; cur != nil; cur = cur.next {
		if cur.Key == KEY {
			return cur.Value, true
		}
	}

	return "", false
}

func main() {
	myMap := NewHashMap(2)
	myMap.Set("小明", "12")
	myMap.Set("小红", "15")
	myMap.Set("小缓缓", "13")

	value, ok := myMap.Get("小缓缓")
	value2, ok2 := myMap.Get("小率")
	fmt.Printf("%s,%v\n", value, ok)
	fmt.Printf("%s,%v\n", value2, ok2)
	fmt.Println(myMap)
}
实现泛型Map
- 使用泛型约束Key,支持string与int类型
- 约定最小容量
- 优化负载因子计算避免精度问题
- 约定扩容上限
- 增加Size(),Keys(),Values()等方法
package main

import (
	"fmt"
	"strings"
)

// 类型约束:规定哪些字段作为Key能被Hash
type BuiltinKey interface {
	int | string
}

type Node[K BuiltinKey, V any] struct {
	Key   K
	Value V
	next  *Node[K, V]
}

type hashTable[K BuiltinKey, V any] []*Node[K, V]

type HashMap[K BuiltinKey, V any] struct {
	hashTable hashTable[K, V]
	size      int
	capacity  int
}

const (
	defaultCapacity = 16 // 非法容量时的回退值
	loadFactorNum   = 3  // 负载因子 0.75 = 3/4
	loadFactorDen   = 4  //
	maxInt          = int(^uint(0) >> 1)
)

func NewHashMap[K BuiltinKey, V any](capacity int) *HashMap[K, V] {
	if capacity <= 0 {
		capacity = defaultCapacity // 容错:0/负数回退到默认容量,避免除零 panic
	}
	return &HashMap[K, V]{
		hashTable: make(hashTable[K, V], capacity),
		capacity:  capacity,
	}
}

// Size 返回元素个数(补上外部获取 size 的途径)
func (m *HashMap[K, V]) Size() int {
	if m == nil {
		return 0
	}
	return m.size
}

func (m *HashMap[K, V]) String() string {
	if m == nil {
		return "MyMap<nil>"
	}

	var builder strings.Builder
	builder.WriteString(fmt.Sprintf("MyMap{size:%d, capacity:%d, data:{", m.size, m.capacity))

	first := true
	for _, head := range m.hashTable {
		for node := head; node != nil; node = node.next {
			if !first {
				builder.WriteString(", ")
			}
			builder.WriteString(fmt.Sprintf("%#v:%#v", node.Key, node.Value))
			first = false
		}
	}

	builder.WriteString("}}")
	return builder.String()
}

// index 获得桶下标
func (m *HashMap[K, V]) index(key K) int {
	var h uint64
	switch k := any(key).(type) {
	case int:
		// 位混合:避免“恒等hash + 2的幂容量”导致分布集中(如全偶数key挤在一个桶)
		h = uint64(k) * 0x9E3779B97F4A7C15
		h ^= h >> 30
	case string:
		h = stringHash(k)
	}
	return int(h % uint64(m.capacity))
}

func stringHash(key string) uint64 {
	var h uint64 = 14695981039346656037 // FNV-1a offset basis

	for i := 0; i < len(key); i++ {
		h ^= uint64(key[i])
		h *= 1099511628211
	}

	return h
}

// expandHashTable 扩容为 2 倍并重新散列
func (m *HashMap[K, V]) expandHashTable() {
	if m.capacity > maxInt/2 { // 容量翻倍会溢出
		return
	}

	oldTable := m.hashTable
	m.capacity *= 2
	m.hashTable = make(hashTable[K, V], m.capacity)

	for _, node := range oldTable {
		for node != nil {
			next := node.next

			idx := m.index(node.Key)
			node.next = m.hashTable[idx]
			m.hashTable[idx] = node

			node = next
		}
	}
}

func (m *HashMap[K, V]) Set(key K, value V) {
	idx := m.index(key)

	// 已存在则更新,直接返回(不会误触发扩容)
	for cur := m.hashTable[idx]; cur != nil; cur = cur.next {
		if cur.Key == key {
			cur.Value = value
			return
		}
	}

	// 负载因子达到阈值时扩容:size/capacity >= 3/4 ⇔ size*4 >= capacity*3
	if m.size*loadFactorDen >= m.capacity*loadFactorNum {
		m.expandHashTable()
		idx = m.index(key) // 扩容后重新计算待插入下标
	}

	m.hashTable[idx] = &Node[K, V]{
		Key:   key,
		Value: value,
		next:  m.hashTable[idx],
	}
	m.size++
}

// Get 返回 V 本体和命中标志;未命中返回 V 的零值
func (m *HashMap[K, V]) Get(key K) (V, bool) {
	var zero V
	if m == nil {
		return zero, false
	}

	idx := m.index(key)
	for cur := m.hashTable[idx]; cur != nil; cur = cur.next {
		if cur.Key == key {
			return cur.Value, true
		}
	}

	return zero, false
}

func (m *HashMap[K, V]) Delete(key K) bool {
	if m == nil {
		return false
	}

	idx := m.index(key)
	node := m.hashTable[idx]

	var prev *Node[K, V]

	for node != nil {
		if node.Key == key {
			if prev == nil {
				m.hashTable[idx] = node.next
			} else {
				prev.next = node.next
			}
			m.size--
			return true
		}

		prev = node
		node = node.next
	}

	return false
}

// Contains 判断 key 是否存在
func (m *HashMap[K, V]) Contains(key K) bool {
	_, ok := m.Get(key)
	return ok
}

// Range 遍历所有键值对,回调返回 false 可提前终止
func (m *HashMap[K, V]) Range(fn func(key K, value V) bool) {
	if m == nil {
		return
	}
	for _, head := range m.hashTable {
		for node := head; node != nil; node = node.next {
			if !fn(node.Key, node.Value) {
				return
			}
		}
	}
}

// Keys 返回所有键
func (m *HashMap[K, V]) Keys() []K {
	if m == nil {
		return nil
	}
	keys := make([]K, 0, m.size)
	m.Range(func(k K, _ V) bool {
		keys = append(keys, k)
		return true
	})
	return keys
}

// Values 返回所有值
func (m *HashMap[K, V]) Values() []V {
	if m == nil {
		return nil
	}
	values := make([]V, 0, m.size)
	m.Range(func(_ K, v V) bool {
		values = append(values, v)
		return true
	})
	return values
}

// Clear 清空
func (m *HashMap[K, V]) Clear() {
	if m == nil {
		return
	}
	m.hashTable = make(hashTable[K, V], m.capacity)
	m.size = 0
}

func main() {
	myMap := NewHashMap[int, string](2)
	myMap.Set(1002, "小红")
	myMap.Set(1003, "小绿")
	myMap.Set(1004, "小黑")

	// Get 直接返回 string 类型,不再需要类型断言
	v1, ok1 := myMap.Get(1002)
	v2, ok2 := myMap.Get(1003)
	v3, ok3 := myMap.Get(9999) // 未命中 -> 零值 "" + false
	fmt.Printf("Get(1002)=%q ok=%v\n", v1, ok1)
	fmt.Printf("Get(1003)=%q ok=%v\n", v2, ok2)
	fmt.Printf("Get(9999)=%q ok=%v\n", v3, ok3)
	fmt.Println("Size:", myMap.Size())
	fmt.Println(myMap)

	myMap.Delete(1004)
	myMap.Set(1003, "小黑")
	fmt.Println("Contains(1004):", myMap.Contains(1004))
	fmt.Println("Keys:", myMap.Keys())
	fmt.Println("Values:", myMap.Values())

	fmt.Println("Range 遍历(遇到 1003 提前停止):")
	myMap.Range(func(k int, v string) bool {
		fmt.Printf("  %d -> %s\n", k, v)
		return k != 1003
	})
	fmt.Println(myMap)

	// 边界:容量 0 / 负数不再 panic
	zero := NewHashMap[string, int](0)
	zero.Set("k", 1)
	vz, okz := zero.Get("k")
	fmt.Printf("NewHashMap(0) 正常使用: %d %v\n", vz, okz)
}
评论(0)
暂无评论